
3줄 요약
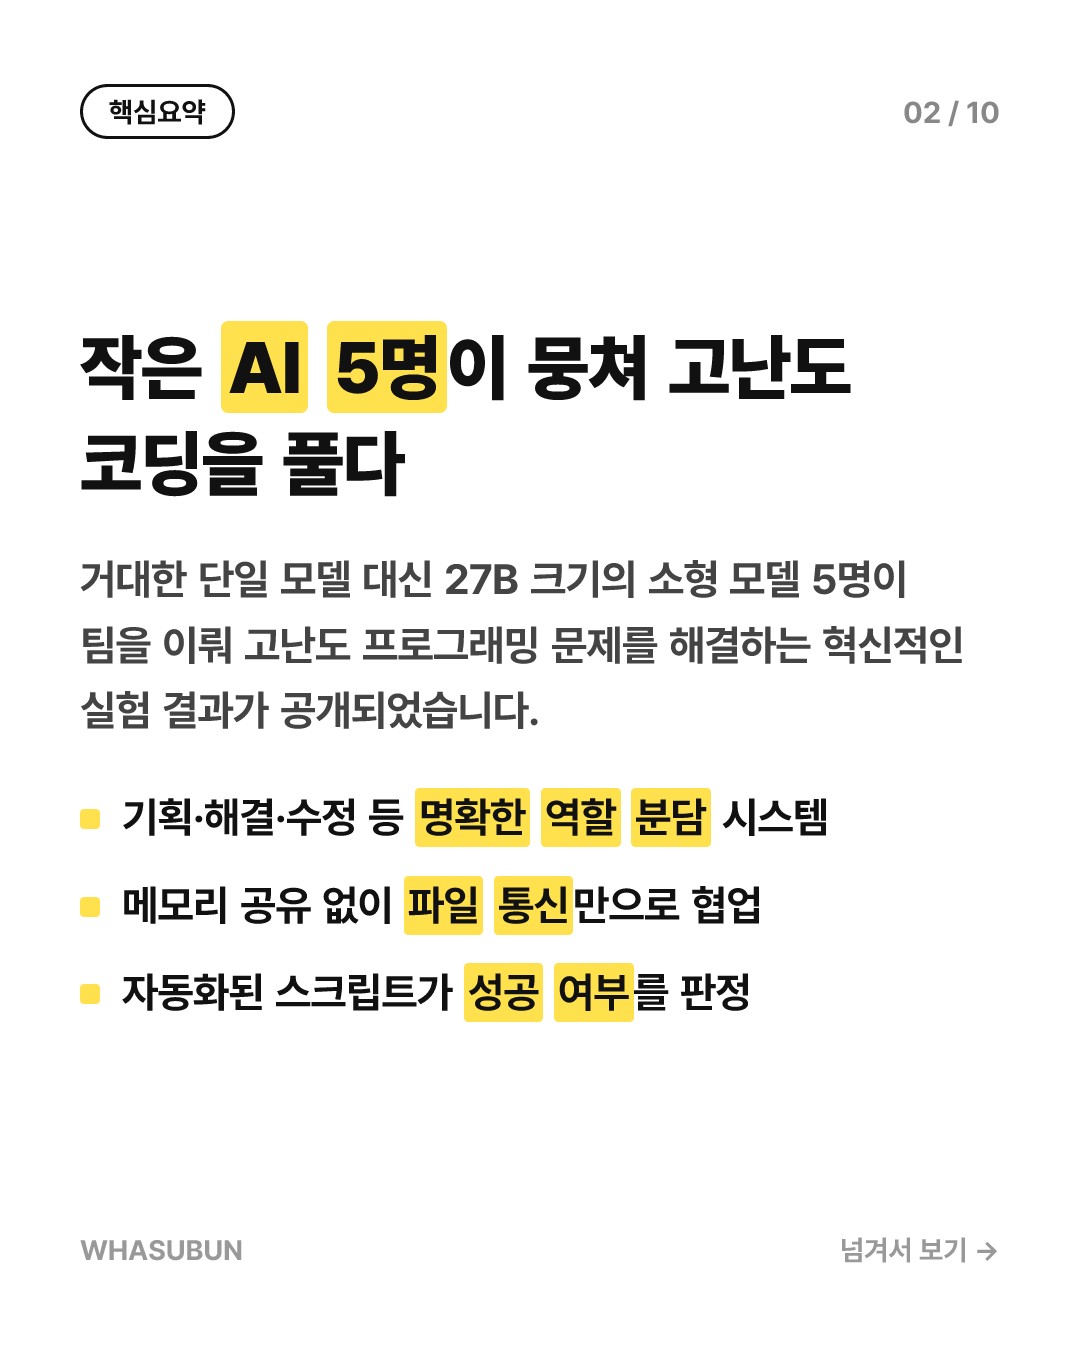
1. 27B 크기의 Qwen 모델 5개가 역할을 나눠 코딩 문제를 해결했습니다.
2. 파일을 통해서만 소통하는 독특한 다중 협업 구조로 성능을 극대화했습니다.
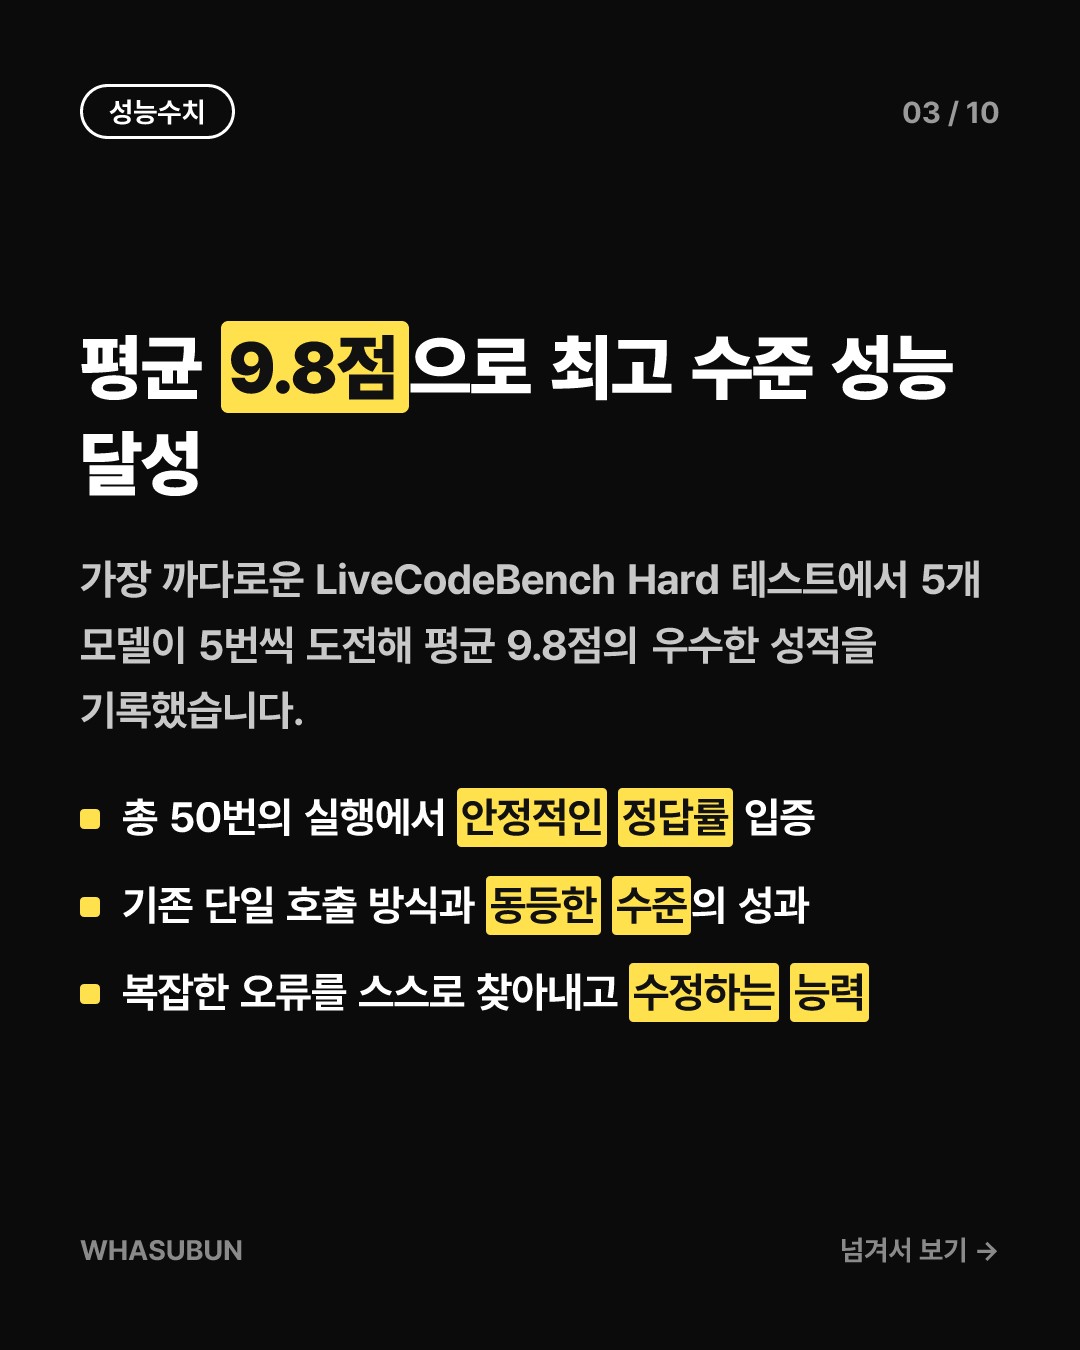
3. 가장 까다로운 LiveCodeBench Hard 테스트에서 우수한 성과를 거뒀습니다.
똑똑한 거대 AI 하나보다, 역할 분담한 작은 AI 5명이 낫다
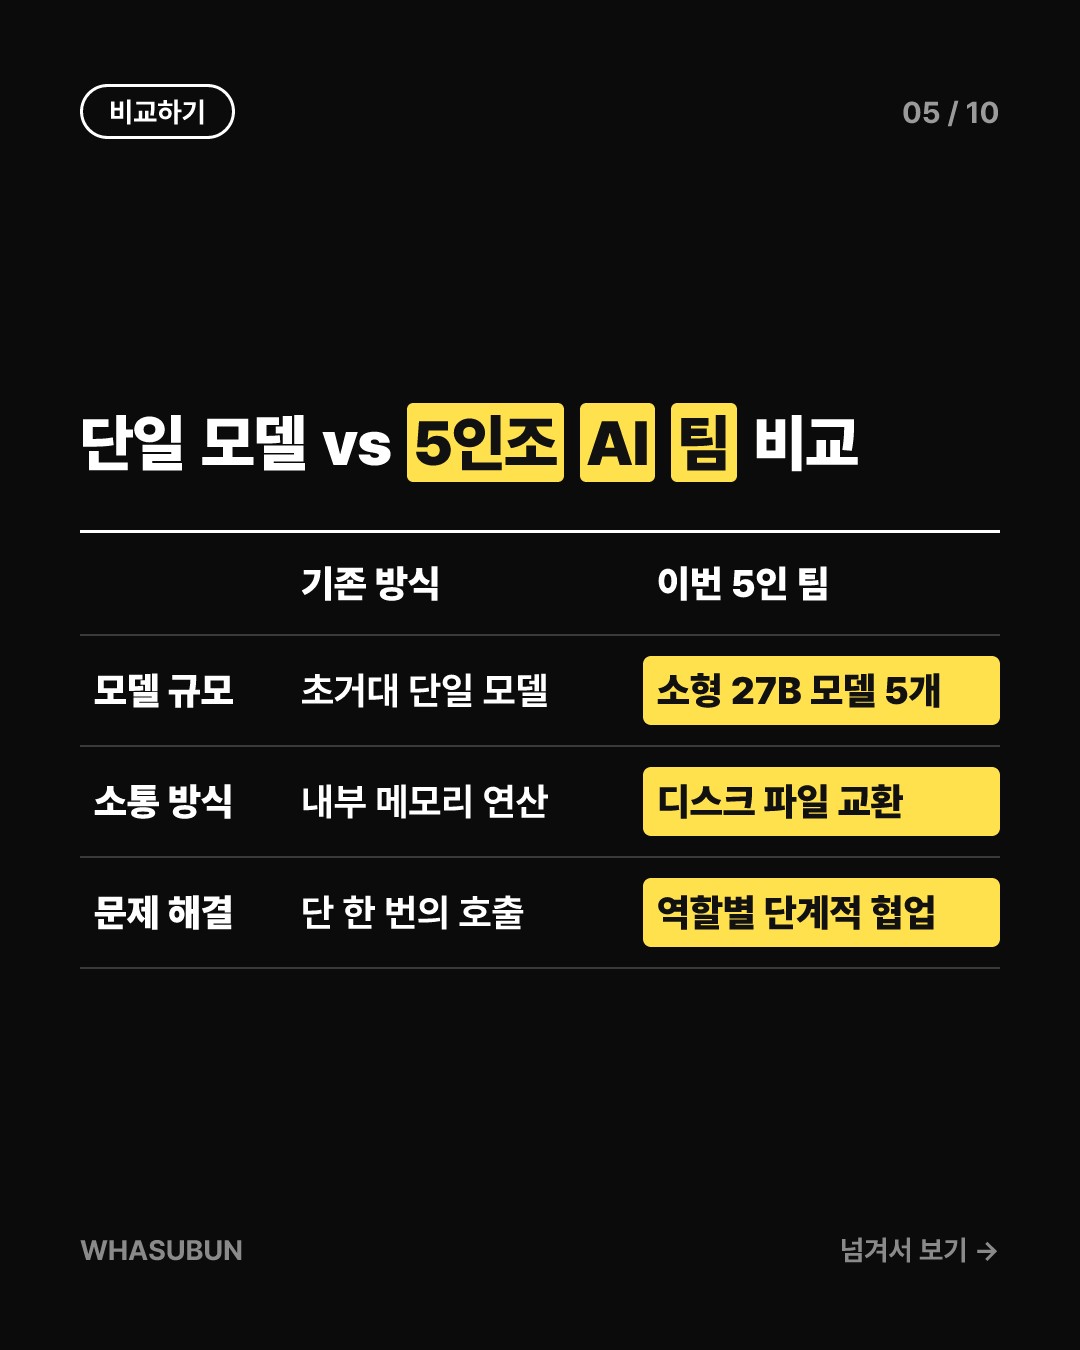
최근 AI 업계에서는 거대한 단일 모델 하나에만 의존하는 방식에서 벗어나, 여러 개의 모델이 협력하는 멀티에이전트 시스템에 주목하고 있습니다. 오픈소스 모델인 Qwen(27B) 기반의 소형 모델 5개가 팀을 이루어 고난도 코딩 테스트인 LiveCodeBench Hard에 도전했습니다. 이들은 기획자, 아이디어 제공자, 해결사, 관리자, 그리고 수정 담당자까지 각자 명확한 역할을 맡아 움직입니다.
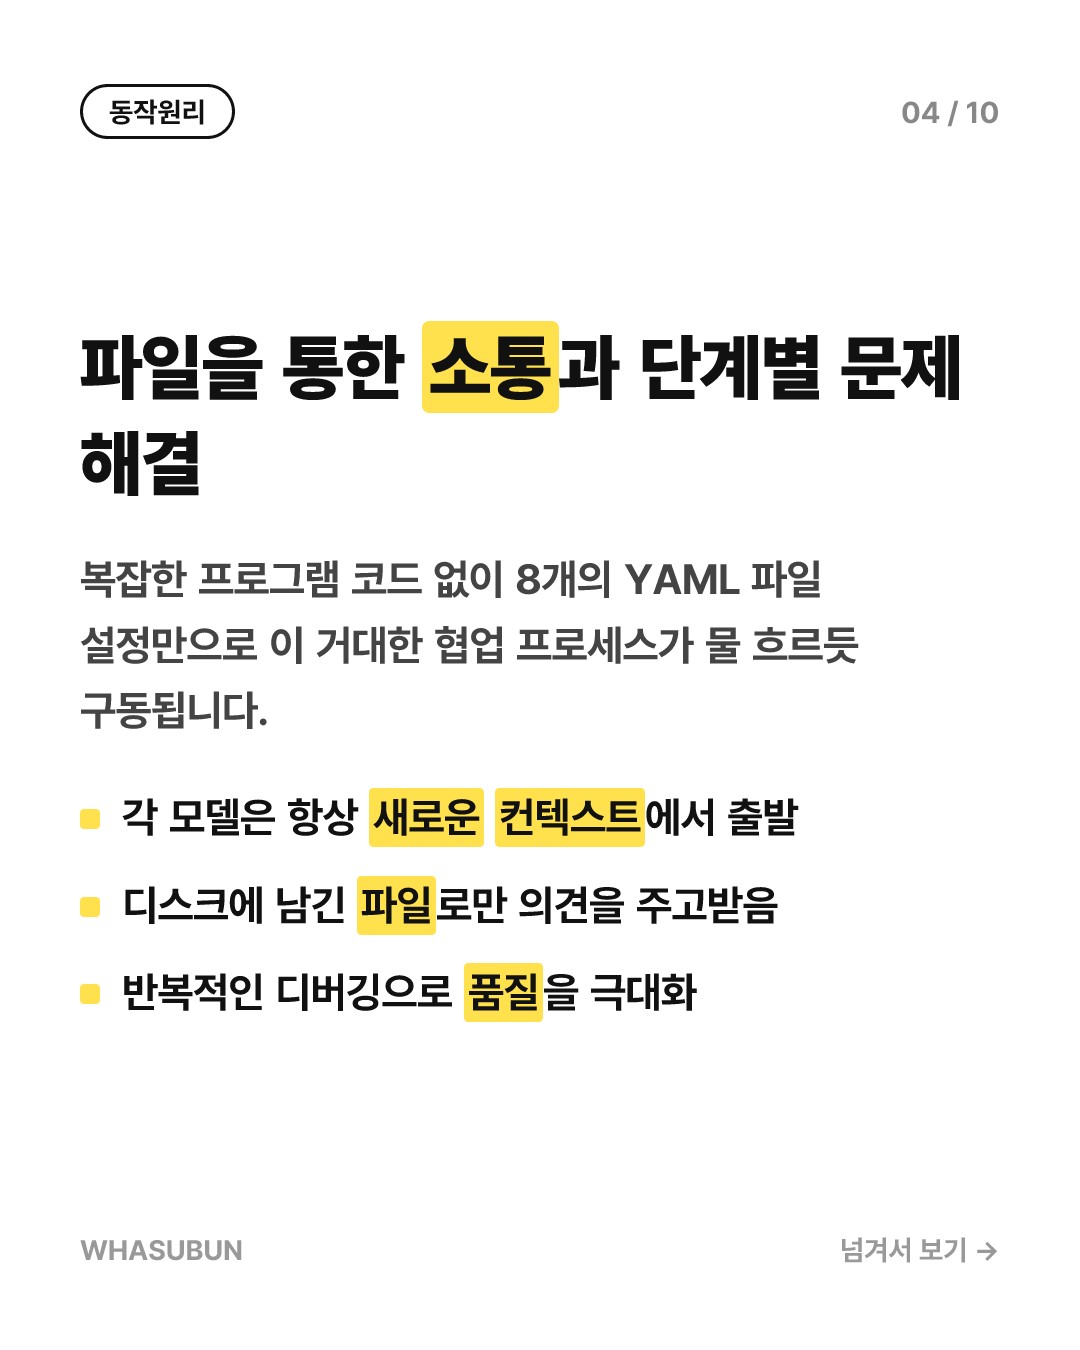
흥미로운 점은 이들이 서로 메모리를 공유하지 않고 오직 디스크에 저장된 파일을 통해서만 대화한다는 것입니다. 각자 완전히 새로운 상태에서 시작해 파일로 의견을 교환하며 코드를 다듬어 나갑니다. 모델의 성공 여부는 사람이 주관적으로 판단하는 것이 아니라, 철저하게 자동화된 채점 스크립트가 검증합니다.
철저한 역할 분담과 파일 통신이 만든 놀라운 결과
이번 실험에서 사용된 방법론은 복잡한 내부 코드 없이 오직 8개의 YAML 파일 설정만으로 구현되었습니다. 5개의 작은 모델은 기획부터 최종 코드 수정까지 유기적으로 맞물려 돌아갑니다. 단일 호출 방식으로 문제를 푸는 기존 방식에 비해, 여러 단계를 거치며 스스로 오류를 잡는 구조가 핵심 경쟁력입니다.
실험 결과, 이 5인조 AI 팀은 LiveCodeBench Hard의 까다로운 문제들에서 평균 9.8점이라는 높은 점수를 기록했습니다. 단 한 번의 호출로 문제를 해결하는 기존 방식과 비교해도 손색이 없거나 오히려 뛰어넘는 정확도를 보여주었습니다. 특히 복잡한 알고리즘 문제를 풀 때 반복적인 수정 과정을 거치며 정답률을 극적으로 끌어올렸습니다.
한 번 실행하는 데 드는 시간과 비용은 어느 정도일까?
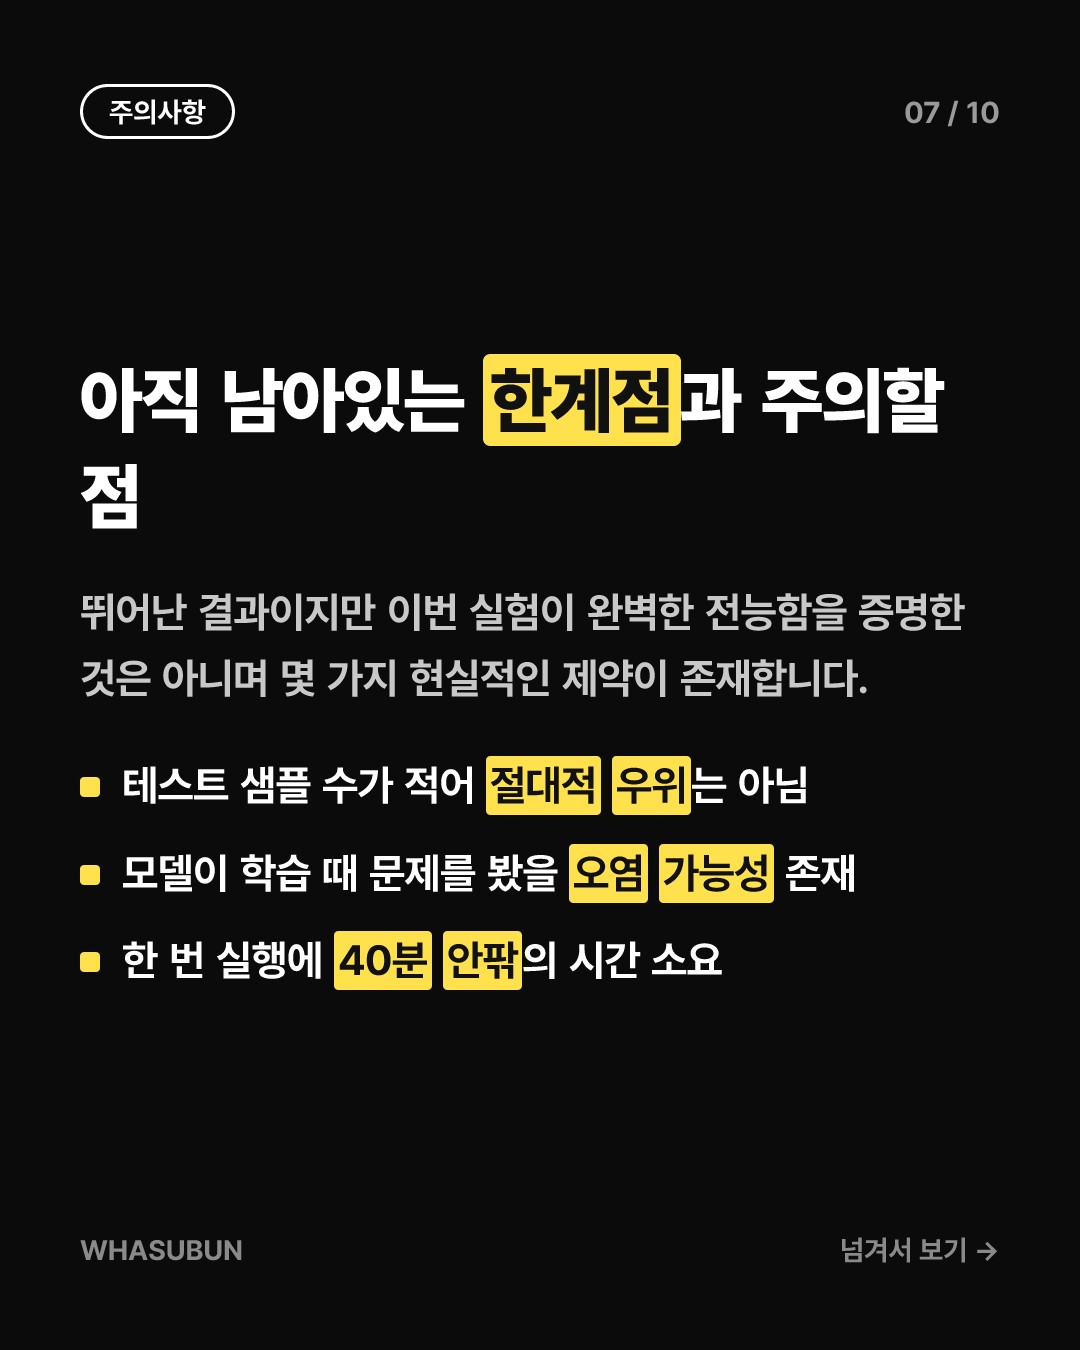
고성능 AI 시스템이라고 하면 엄청난 비용과 인프라가 필요할 것 같지만, 이번 실험은 의외로 합리적인 수치를 보여줍니다. 50번의 전체 실행 테스트를 진행하는 동안 한 번 실행하는 데 걸린 시간은 중간값 기준으로 약 40분이었습니다. 비용 역시 회당 0.39달러 수준으로, 50회를 모두 돌리는 데 약 35.79달러가 소모되었습니다.
물론 이 결과가 기존 모델을 완전히 압도하는 절대적인 우위를 뜻하는 것은 아닙니다. 연구진은 이번 실험의 목적이 기존 하네스(테스트 도구)와 동등한 수준의 성능을 구현하는 것임을 분명히 했습니다. 출제된 문제들이 2025년 봄에 나온 것들이라 모델이 학습 과정에서 이미 접했을 가능성(데이터 오염)도 배제할 수 없습니다.
그래서 우리 개발 환경과 일상에는 어떤 변화가 생길까?
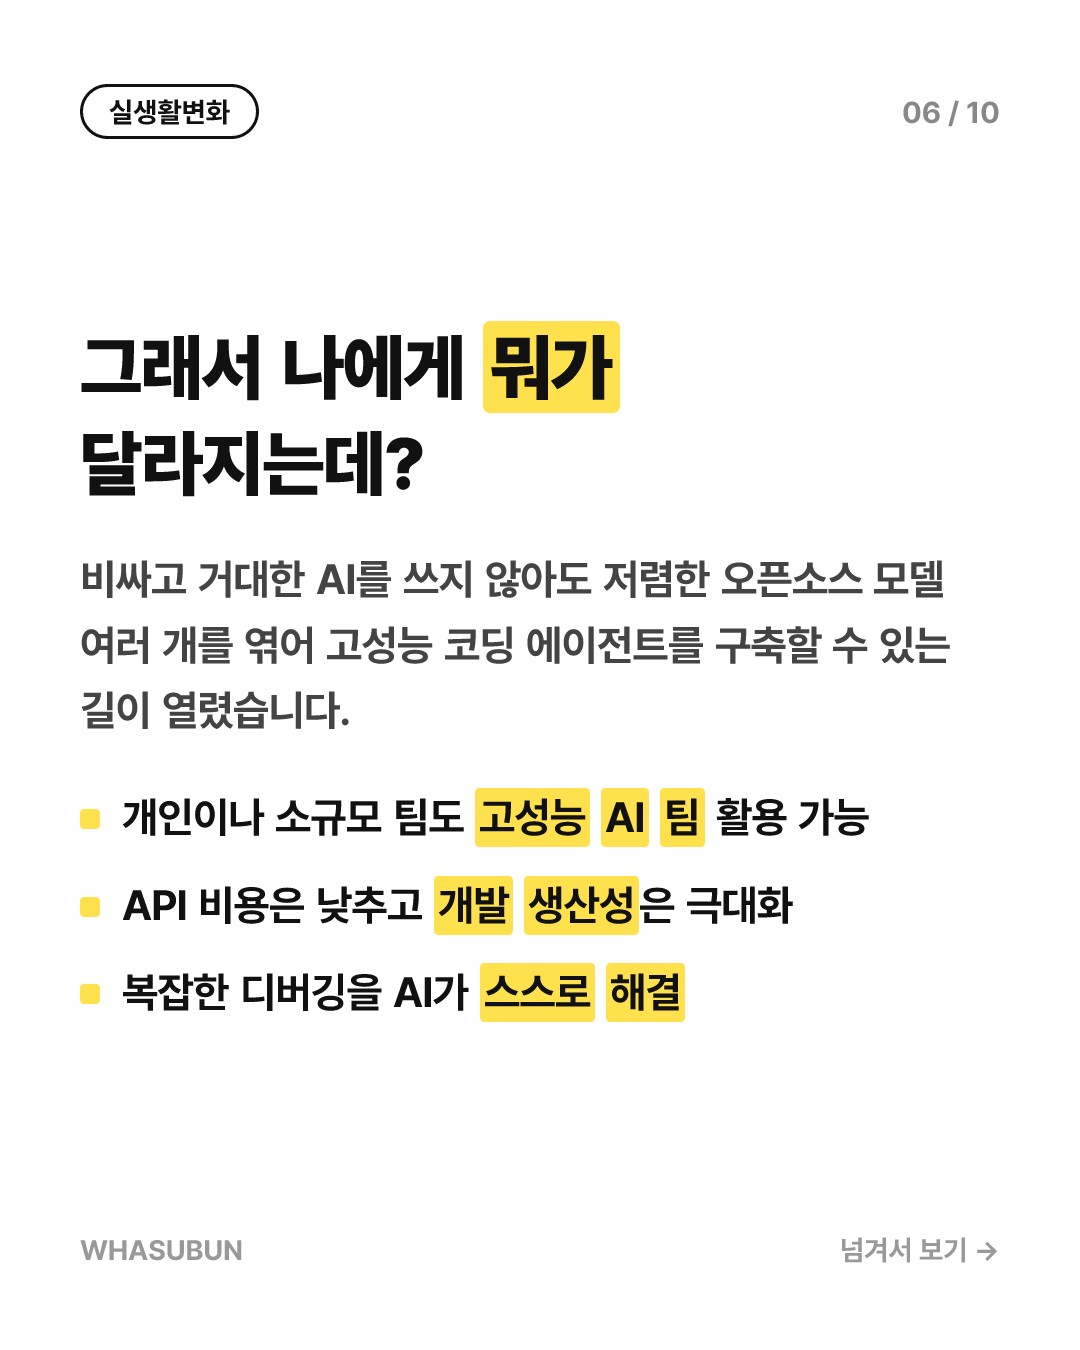
이번 연구는 거대하고 비싼 AI 모델을 무조건 키우는 것만이 답이 아님을 증명합니다. 비교적 가벼운 오픈소스 모델 여러 개를 체계적으로 엮는 것만으로도 최고 수준의 코딩 능력을 발휘할 수 있습니다. 이는 앞으로 개발자들이 개인용 컴퓨터나 저렴한 서버 환경에서도 고성능 AI 협업 코딩 시스템을 구축할 수 있는 가능성을 열어줍니다.
복잡한 소프트웨어 개발 프로젝트에서 AI가 기획, 구현, 디버깅을 스스로 분담해 처리하는 시대가 성큼 다가왔습니다. API 비용 부담을 줄이면서도 정확도를 높일 수 있는 실용적인 방법론이 제시된 셈입니다. 앞으로 AI 에이전트들이 어떻게 실무 개발 영역에 스며들지 기대를 모으는 이유입니다.
카드뉴스로 한눈에 보기
자주 묻는 질문
Q. 작은 AI 모델 5명이 어떻게 협력하나요?
기획자, 아이디어 제공자, 해결사, 관리자, 수정 담당자로 역할을 나누어 각자 독립된 상태에서 디스크에 저장된 파일을 통해서만 소통하며 코드를 완성합니다.
Q. 실행하는 데 비용과 시간이 얼마나 걸리나요?
한 번 문제를 푸는 데 중간값 기준으로 약 40분이 소요되며, 비용은 약 0.39달러(50회 총비용 약 35.79달러)로 비교적 저렴한 편입니다.
Q. 이 방식이 기존 방식보다 무조건 더 뛰어난가요?
기존 대형 모델과 동등한 수준의 성능(파리티)을 낸다는 것을 증명한 것이며, 문제 출제 시기와 모델 학습 데이터 겹침 등의 한계는 여전히 존재합니다.
참고: Hacker News — Memdoor: A team of 5 Qwen3.8-27B models beats Fable 5 on LiveCodeBench Hard
다음 신기술 소식도 놓치지 마세요
어렵게만 느껴지던 과학·AI·전자제품 이야기를 매일 쉽고 재밌게 풀어드려요. 저장하고 팔로우하면 내일 더 신기한 소식이 옵니다.
THREADS → @2days.kr
NAVER → blog.naver.com/brook-pd
BLOG → whasubun.blogspot.com
댓글 쓰기